
플랜트 ML 실패는 자주 “drift”나 “모델이 낡았다”로 탓한다. 때로 분포가 실제로 이동했다. 때로 training과 serving이 처음부터 같은 것을 계산하지 않았다.
Historian alias 충돌과 NTP 시계 왜곡은 라벨과 시간을 오염시킨다. Label noise는 비전 상한을 제한한다. 이 글은 training–serving skew다: 모델을 만든 노트북과 라이브 태그를 스코어링하는 서비스 사이에서 갈라지는 feature 로직.
두 파이프라인, 하나의 이름
Training은 이력 extract를 가져온다: join, 리샘플링, 단위 변환, clipping, imputation, lag feature가 한 스크립트 버전 아래 조립된다. Serving은 다른 경로로 라이브 태그를 읽는다—PLC alias, edge aggregator, 또는 “임시” SQL view—그리고 latency를 맞추려 줄인 transform을 적용한다. 모델 파일은 같다. Feature 벡터는 아니다.
가벼운 drift처럼 보이는 skew
Training에서 5분, serving에서 1 sample인 lag. Training warehouse에서는 °C, 라이브 태그에서는 변환 없이 °F인 온도. Training에서는 미지 레벨을 영으로 떨어뜨리고 production에서는 기본값에 매핑하는 grade one-hot. Offline AUC는 예쁘게 유지되고, 온라인 조언은 한 제품군을 체계적으로 놓친다.
거짓을 줄이는 통제
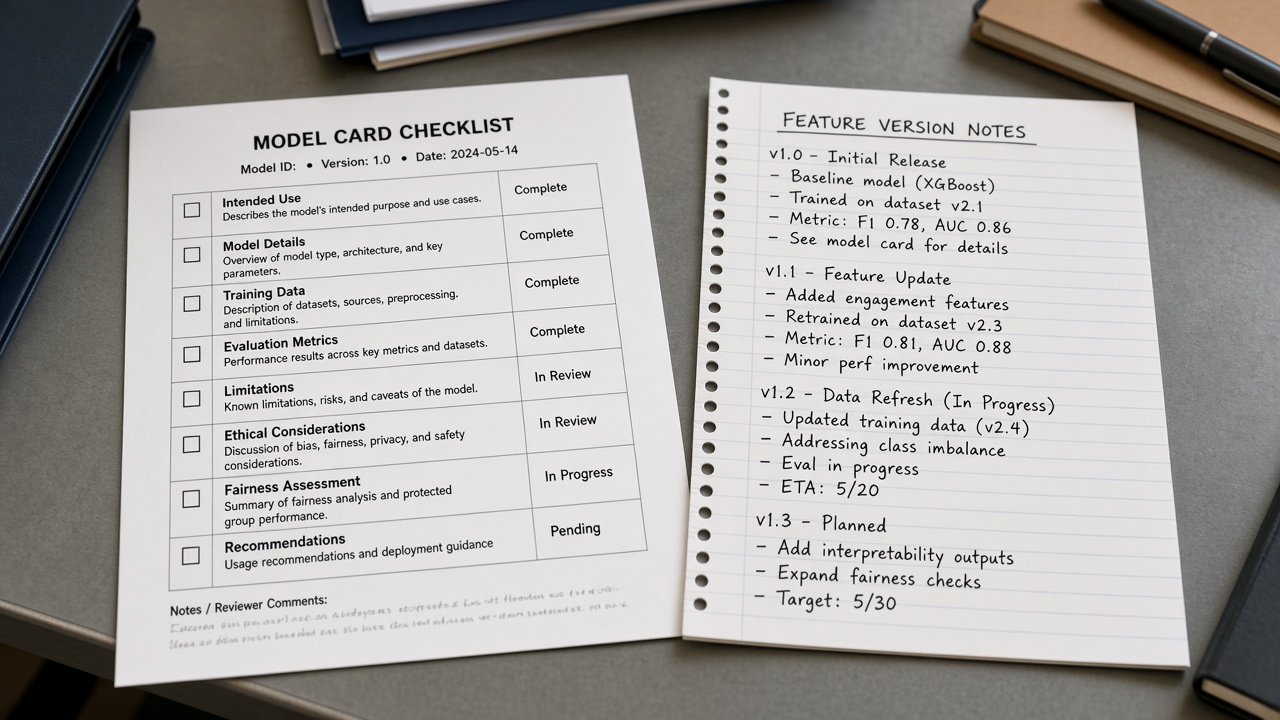
Feature 코드를 모델 아티팩트처럼 버전 관리하라. Train과 serve에 가능하면 하나의 공유 라이브러리·정의를 써라. Shadow-score: 최근 윈도우에 training 스타일 feature를 계산해 라이브 feature 로그와 비교한 뒤 promote하라. 스코어링된 모든 이벤트에 feature-version과 model-version을 넣어 post-mortem이 “AI 품질” 논쟁 대신 불일치를 보게 하라.
깨진 라이브 경로를 문서화해 이제 표준이라고 하지 않은 채, 그 경로로 재학습해 skew를 고치지 말라—모델에게 버그를 기대하도록만 가르친다.
Training과 serving이 입력에서 합의하지 못하면 하이퍼파라미터 탐색으로도 권고를 고칠 수 없다. 먼저 feature를 맞추고, 그다음 알고리즘을 논하라.