
Tesis ML başarısızlıkları çoğu zaman “drift”e veya “model bayatladı”ya bağlanır. Bazen dağılım gerçekten kaymıştır. Bazen training ve serving hiç aynı şeyi hesaplamamıştır.
Historian alias çarpışmaları ve NTP saat kayması etiketleri ve zamanı zehirler. Label noise vision tavanlarını sınırlar. Bu yazı training–serving skew hakkındadır: modeli kuran notebook ile canlı tag’leri skorlayan servis arasında ayrışan feature mantığı.
İki pipeline, bir isim
Training tarihsel bir extract çeker: join’ler, yeniden örnekleme, birim dönüşümü, clipping, imputation ve lag feature’ları tek bir script versiyonu altında birleştirilir. Serving canlı tag’leri farklı bir yoldan okur—PLC alias, edge aggregator veya “geçici” bir SQL view—ve gecikmeyi karşılamak için kısaltılmış transform’lar uygular. Model dosyası aynıdır. Feature vektörü değildir.
Hafif drift gibi görünen skew
Training’de 5 dakika, serving’de 1 sample olan bir lag. Training warehouse’da °C, canlı tag’de dönüşümsüz °F olan bir sıcaklık. Training’de bilinmeyen seviyeyi sıfıra düşüren, production’da varsayılana mapleyen bir grade one-hot. Offline AUC güzel kalır; online tavsiye sistematik olarak bir ürün ailesini kaçırır.
Yalanı azaltan kontroller
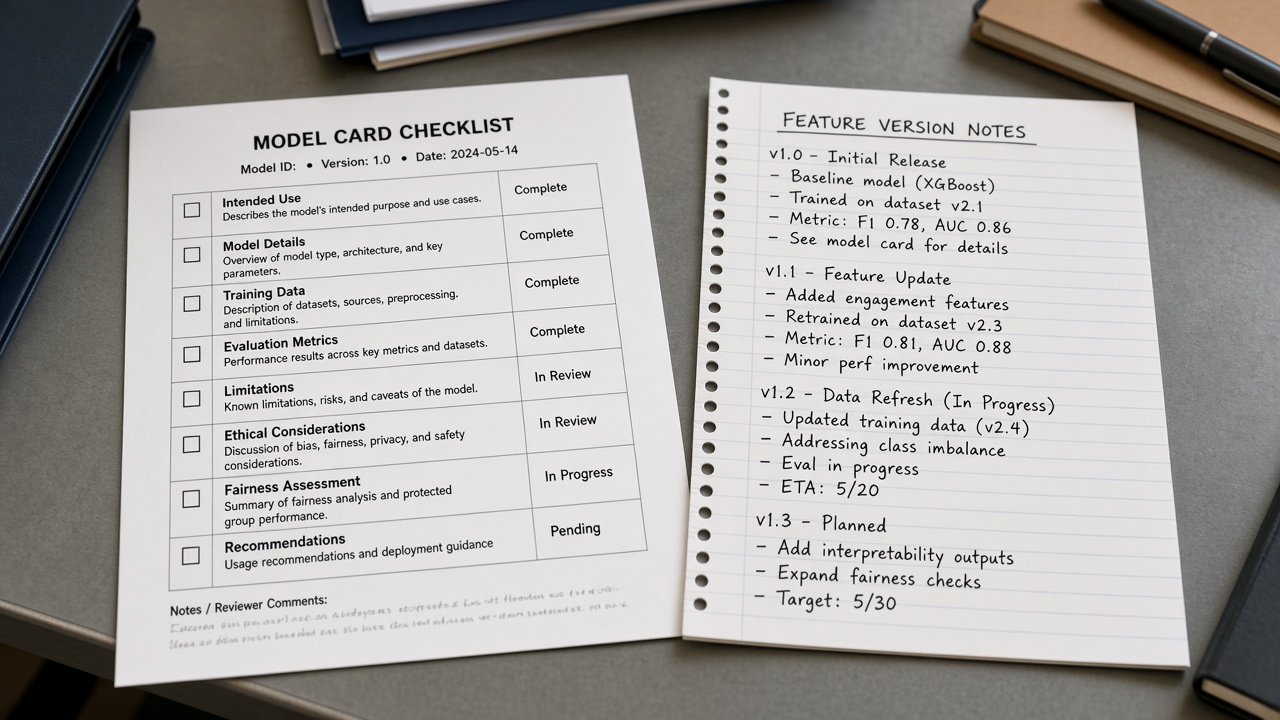
Feature kodunu model artefact’ı gibi versiyonlayın. Train ve serve için tercihen tek paylaşılan kütüphane veya tanım kullanın. Shadow-score: yakın bir pencerede training-tarzı feature’ları hesaplayıp canlı feature log’larıyla karşılaştırın—promote etmeden önce. Her skorlanan olaya feature-version ve model-version koyun ki post-mortem’ler “AI kalitesi” tartışmak yerine uyumsuzluğu görsün.
Bozuk canlı yolu belgelemeden, o yolu artık standart saymadan skew’i yeniden eğiterek düzeltmeyin—modele yalnızca bug’ı beklemeyi öğretirsiniz.
Training ve serving girdilerde anlaşamıyorsa hiçbir hiperparametre araması tavsiyeyi onarmaz. Önce feature’ları hizalayın; sonra algoritmayı tartışın.