
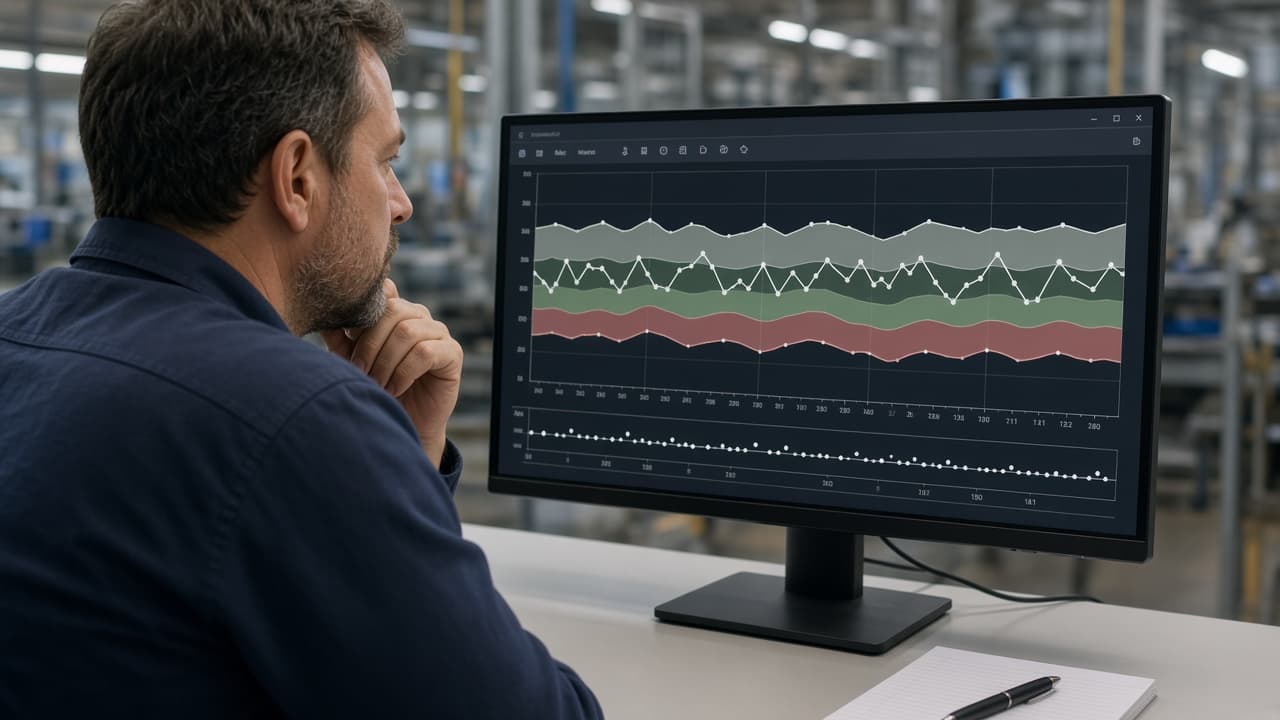
머신러닝 점수는 제조 품질 게이트에 더 자주 나타난다: 예측 결함 확률, 예측 치수, 예측 스크랩 위험. 단일 숫자는 임계값 적용이 쉽다. 오용도 쉽다. 공정이 드리프트하거나, 센서 구성이 바뀌거나, 학습 창이 현재 제품 믹스와 더 이상 맞지 않으면, 그 숫자는 틀어지면서도 자신 있게 남을 수 있다.
MES 체인지오버 소요 추정과 로트 코드 OCR 인쇄 품질은 다른 AI 인접 주제다. 이 글은 품질 예측 주변의 불확실성—왜 점 추정이 출하 결정에 불충분한지—에 관한 것이다.
예측 구간이 더하는 것
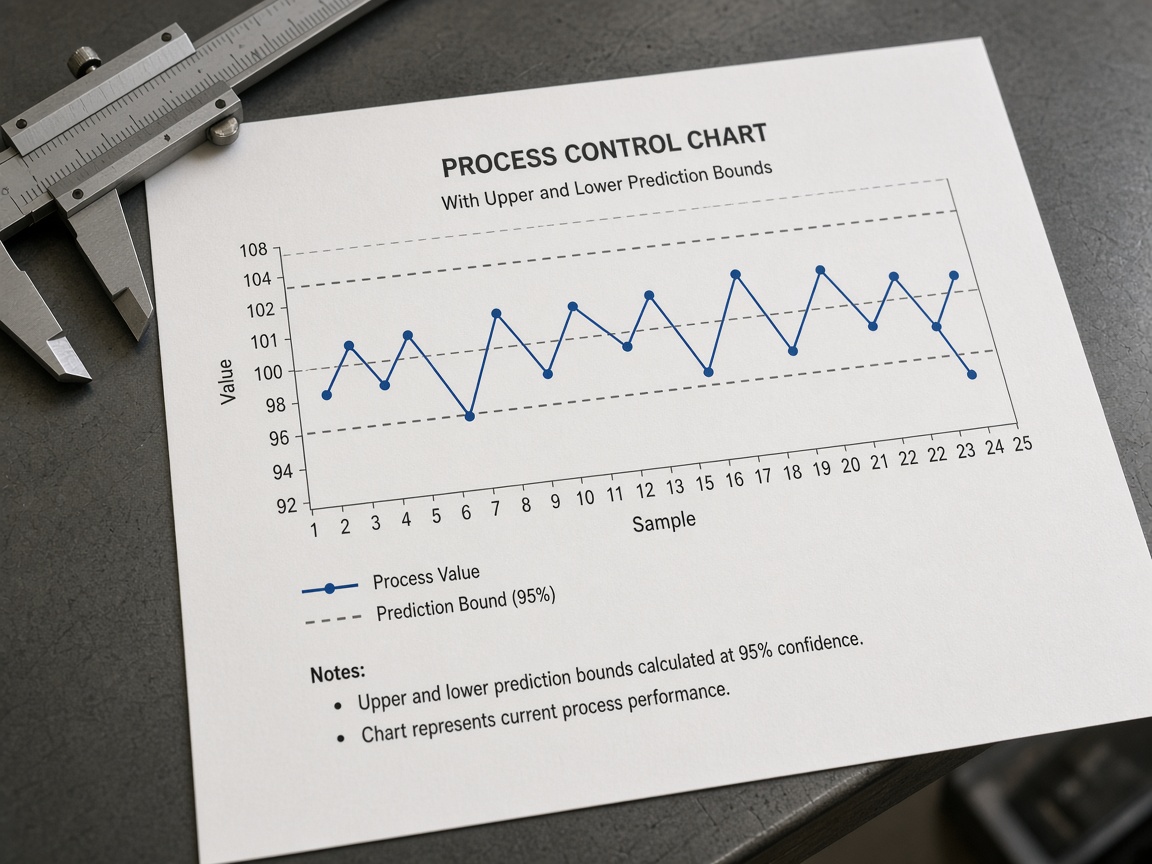
점 예측은 “모델이 어떤 값을 기대하는가?”에 답한다. 구간은 “명시된 가정 아래, 방법이 결과가 어디에 떨어질 가능성이 있다고 주장하는가?”에 답한다. 산업 현장에서 실무 질문은 종종 이렇다: 구간이 규격·관리 한계 안에 완전히 앉는가, 한계와 겹치는가, 밖에 있는가? 이 세 경우는—릴리스, 검사, 홀드—모델이 확실하다고 가장하지 않고도 다른 조치를 뒷받침한다.
Conformal prediction과 관련 교정 기법은 임의 오차 막대보다 명확한 커버리지 특성으로 구간을 붙이기 위해 연구·실무 문헌에서 논의되는 한 계열이다. 구현 세부는 달라진다. 에디토리얼 요점은 변하지 않는다: 결정 정책은 평균 점수만이 아니라 불확실성을 봐야 한다.
수학을 정직하게 유지하는 운영 규칙
- 자재·공구·레시피가 움직이면 정의된 주기로 모델을 재학습하거나 갱신한다. 낡은 모델은 오도할 만큼 좁거나 잘못 중심잡힌 구간을 만든다.
- 학습 지표와 생산 모니터링을 분리한다. 강한 오프라인 점수가 라이브 구간이 여전히 커버함을 증명하지 않는다.
- 어려운 로트를 모니터링 집합에서 조용히 빼 구간을 줄이지 않는다.
- 구간이 임계 한계와 겹치면 사람 경로를 유지한다. 항상 점 추정만 고르는 자동화는 거짓 확신을 다시 만든다.
이 길이의 글이 모든 플랜트에 하나의 알고리즘을 처방할 수는 없다. 고수할 수 있는 것은 표시와 정책 계층이다: 운전원이 초록/빨강 점수만 보면, 자신 있는 정답과 자신 있는 오답을 구별할 수 없다. 대역을 보여 줘라. 게이트에서 그 대역이 무엇을 의미하는지 정의하라. 그러면 모델은 신탁이 아니라—오차 막대가 있는 측정이 된다.