
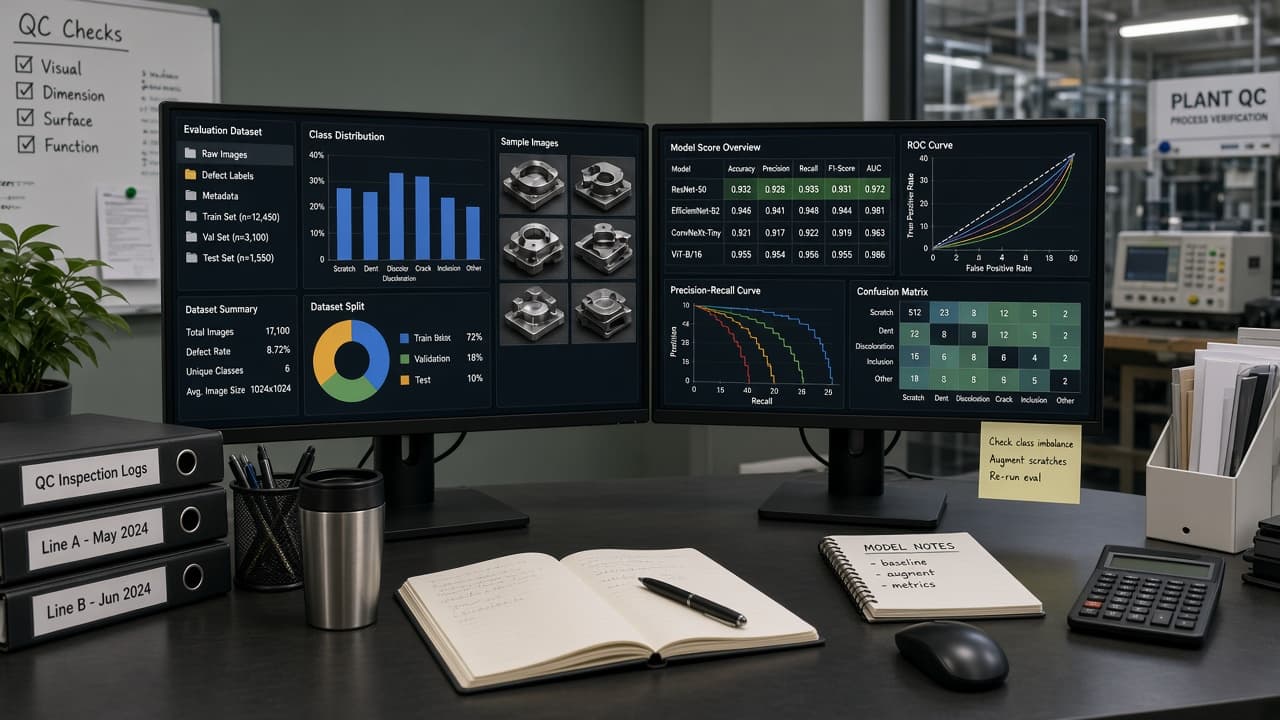
오프라인 보고서에서 수상할 만큼 높고 첫 라이브 주에 실망시키는 품질·소프트센서 모델은 대개 밤새 “잊지” 않았다. 더 자주 평가가 학습 세계를 떠나지 않았다. 양쪽 분할의 같은 로트, 미래 라벨로 계산한 피처, 달력으로 잘라야 할 시계열의 무작위 셔플—어느 것이든 AUC를 부풀리는 동안 라인은 차갑다.
개념 드리프트, 학습–서빙 스큐, 카나리 퍼센트 게이트는 이미 실제를 측정했다고 가정한다. 이 노트는 플랜트 모델의 평가 세트 누출—홀드아웃이 어떻게 오염되고 어떻게 정직하게 유지하는가다.
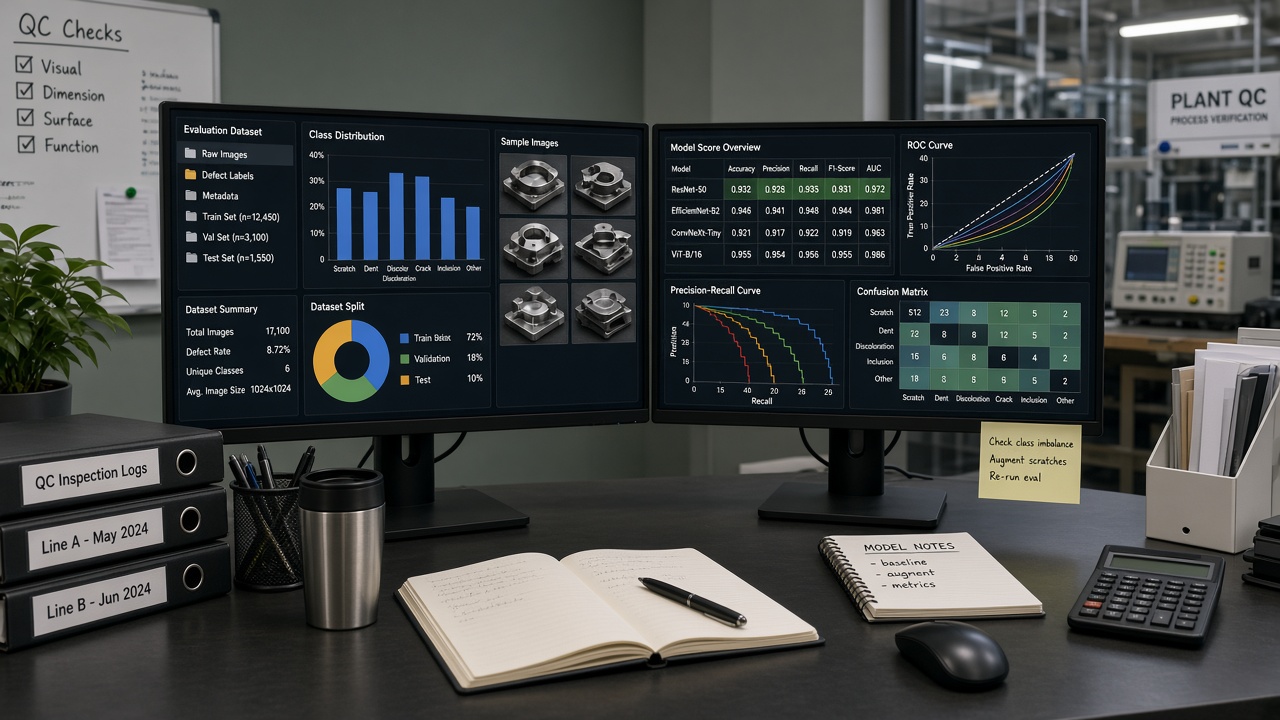
흔한 플랜트 특유 누출:
- 로트·계보 중복. 분할이 행 ID만 키로 써서 자매 웨이퍼나 재작업 시리얼이 train과 test에 같이 들어간다.
- 시간 누출. 연속 공정의 분을 섞으면 인접 샘플이 양쪽에 가고 모델이 국소 레짐을 외운다.
- 라벨 룩어헤드. 점수 시각에 없을 “최종 처분”이나 늦은 랩 결과로 만든 피처.
- 공유 전처리 적합. 스케일러·인코더를 전체 표에 맞춘 뒤 분할 전에 적용—테스트 행이 변환 정의에 기여한다.
- 점수를 광고하는 같은 홀드아웃에서 챔피언 튜닝된 임계값, 중첩·신규 동결 세트 없이.
플랜트 MoC에 맞는 위생
무작위 행이 아니라 시간 또는 생산 캠페인으로 먼저 나눠라. 로트·시리얼·레시피 패밀리로 중복 제거하라. 평가 세트를 날짜와 소유자로 동결하고, 지표를 본 뒤 “어려운 케이스 몇 개”를 슬쩍 넣지 마라. 추론 시각에 허용된 피처를 문서화하라. 노트북 지표가 “작은 데이터 수정” 뒤 뛰어오르면 반증될 때까지 누출로 가정하라.
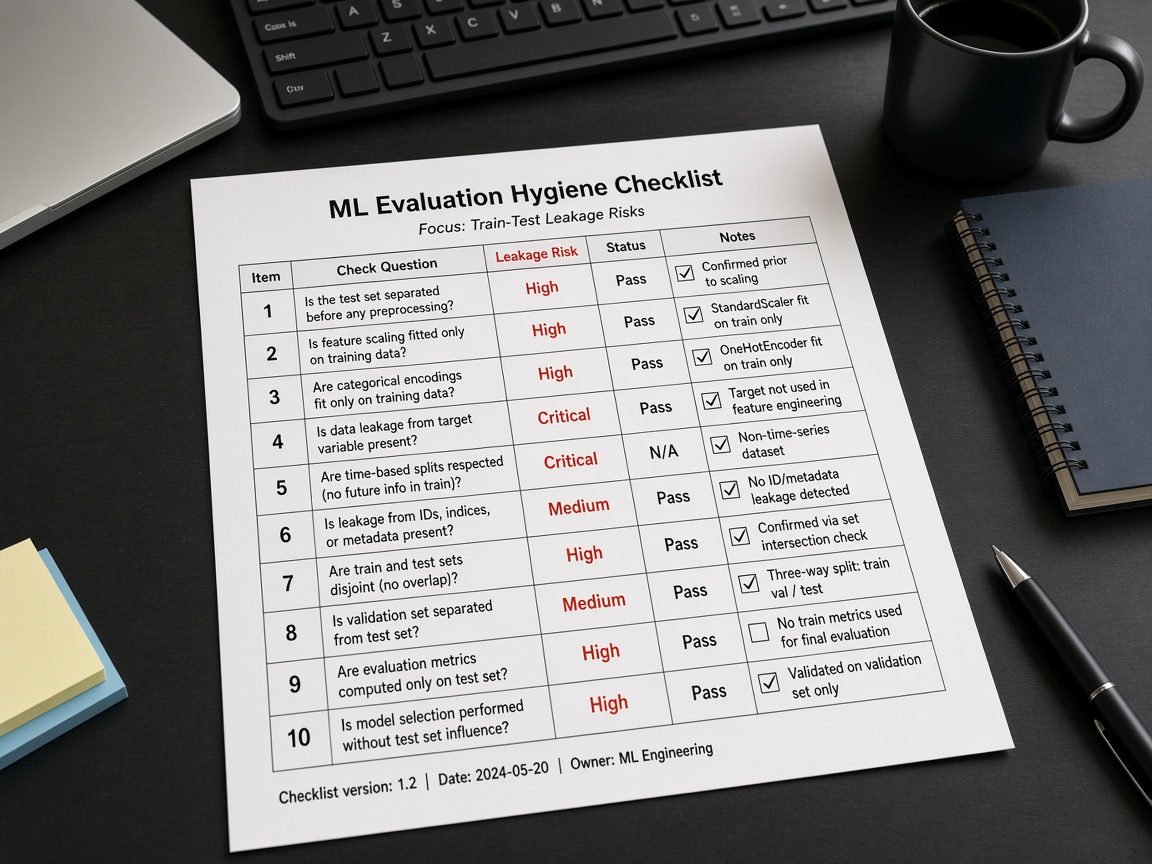
콜드스타트 SKU 계획과 챔피언–챌린저 대결은 깨끗한 스코어카드가 필요하다. 누출은 모든 게이트를 낙관적으로 만든다. 홀드아웃을 통제된 산출물로 두는 플랜트는 모델이 번 것을 배운다. test_final_v3 폴더로 두는 플랜트는 스크랩에서 배운다.